Claude Sonnet 5.5가 나왔습니다
Claude Sonnet 5.5 출시 소식(가격, 속도, Claude Code 반영 시점)을 출처 화면과 함께 정리한 글.
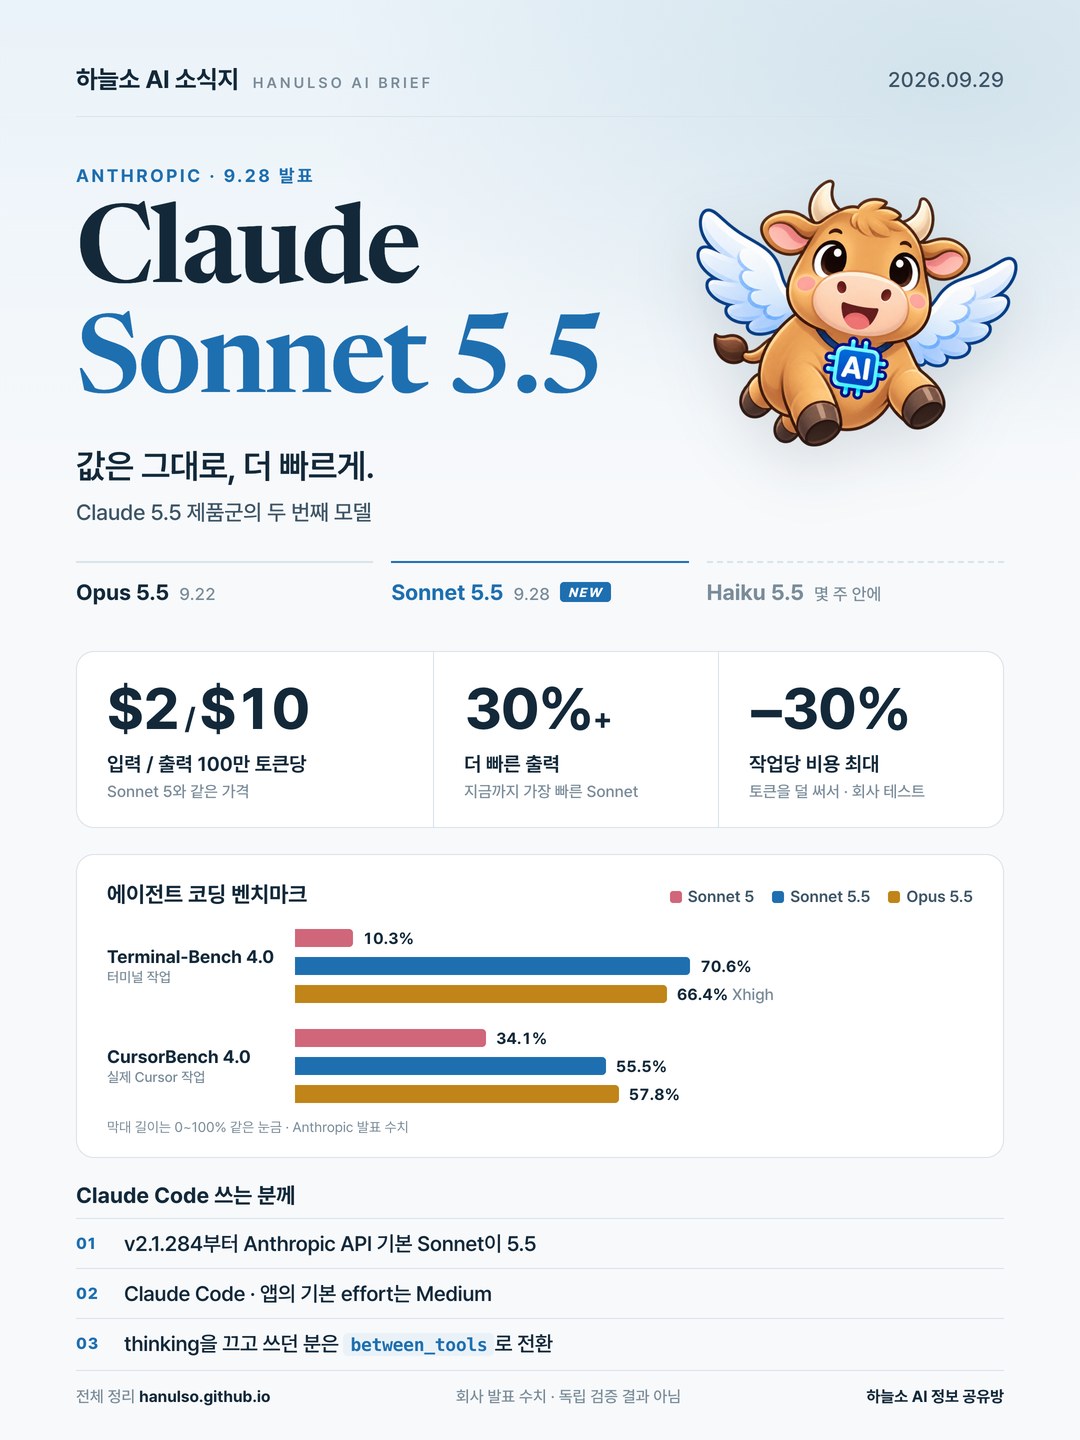
Anthropic이 9월 28일(미국) Claude Sonnet 5.5를 발표했습니다. 지난주 나온 Opus 5.5에 이은 Claude 5.5 제품군의 두 번째 모델입니다. Claude Code에는 v2.1.284(9월 29일 03:02, 한국 시각)로 들어왔습니다. Opus 5.5 소식은 [9월 넷째 주 AI 소식 모음]({{ '/posts/ai-news-2026-09-26/' | relative_url }})에 정리했습니다.
어떤 모델인가
Anthropic은 Sonnet 5.5를 Opus 5.5보다 빠르고 값싸게 곁에 두는 모델로 소개했습니다. Opus 5.5가 신중한 판단이 필요한 복잡한 일을 맡는다면, Sonnet 5.5는 범위가 분명한 일상 작업, 버그 수정, 문서·슬라이드·스프레드시트 만들기에 가장 강하다고 합니다. 디자인 감각도 좋아졌다고 합니다.
대량 처리용 Haiku 5.5는 몇 주 안에 나올 예정입니다.
성능
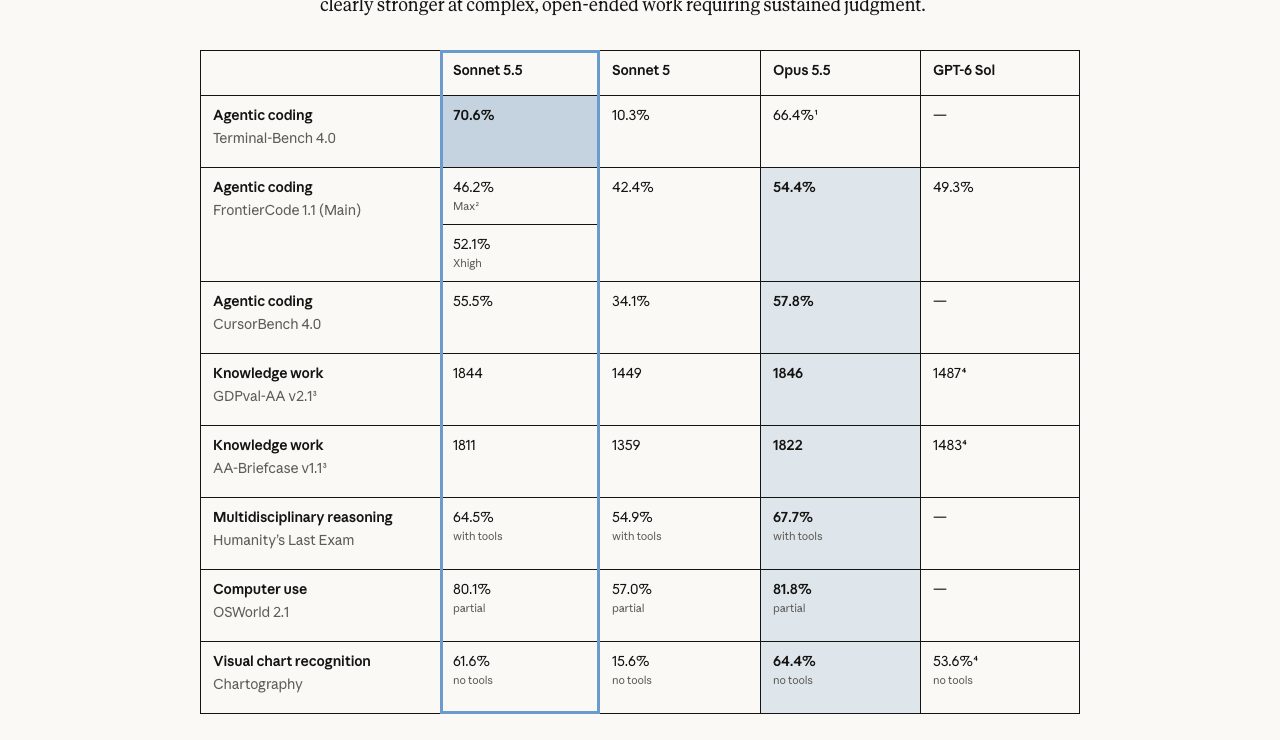
Anthropic이 공개한 표에서 Sonnet 5는 크게 앞질렀고 Opus 5.5와는 많이 좁혀졌습니다.
평가 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
Terminal-Bench 4.0 (에이전트 코딩) | 70.6% | 10.3% | 66.4% |
CursorBench 4.0 (에이전트 코딩) | 55.5% | 34.1% | 57.8% |
FrontierCode 1.1 (에이전트 코딩) | 52.1% (Xhigh) · 46.2% (Max) | 42.4% | 54.4% |
OSWorld 2.1 (컴퓨터 사용) | 80.1% | 57.0% | 81.8% |
Humanity's Last Exam (도구 사용) | 64.5% | 54.9% | 67.7% |
GDPval-AA v2.1 (지식 노동, Elo) | 1844 | 1449 | 1846 |
Terminal-Bench 4.0의 Opus 5.5 점수는 가장 높은 Xhigh 설정 기준입니다.
여러 평가에서 Sonnet 5.5는 Low나 Medium 설정으로도 Sonnet 5의 최고 점수를 넘었고, 작업당 비용은 약 10분의 1이었다고 합니다.
FrontierCode에서 Max 설정 점수가 Xhigh보다 낮은 이유도 밝혔습니다. Max 설정에서는 Claude Code의 코드 리뷰 스킬을 더 자주 실행해 리뷰를 여러 서브에이전트로 나눴습니다. Cognition이 살펴본 두 사례에서는 그 때문에 시간 초과가 나거나 과제 범위 밖까지 고쳐서 점수가 깎였습니다.
Anthropic은 복잡하고 열린 작업에서는 여전히 Opus 5.5가 확실히 낫다고 덧붙였습니다.
가격과 속도
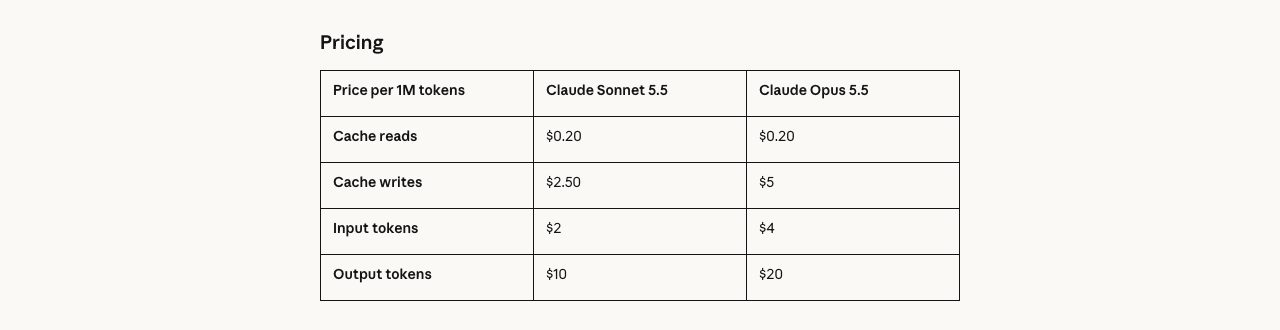
가격은 Sonnet 5와 같습니다. 100만 토큰당 입력 $2, 출력 $10, 캐시 읽기 $0.20, 캐시 쓰기 $2.50입니다. Opus 5.5는 $4, $20, $0.20, $5입니다.
작업당 비용은 줄었습니다. 같은 일을 훨씬 적은 토큰으로 끝내서, Anthropic 테스트에서는 작업당 비용이 Sonnet 5보다 최대 30% 적었습니다.
출력이 30% 넘게 빨라졌습니다. 지금까지 가장 빠른 Sonnet이라고 합니다.
Claude Code를 쓰는 분이 알아 둘 것
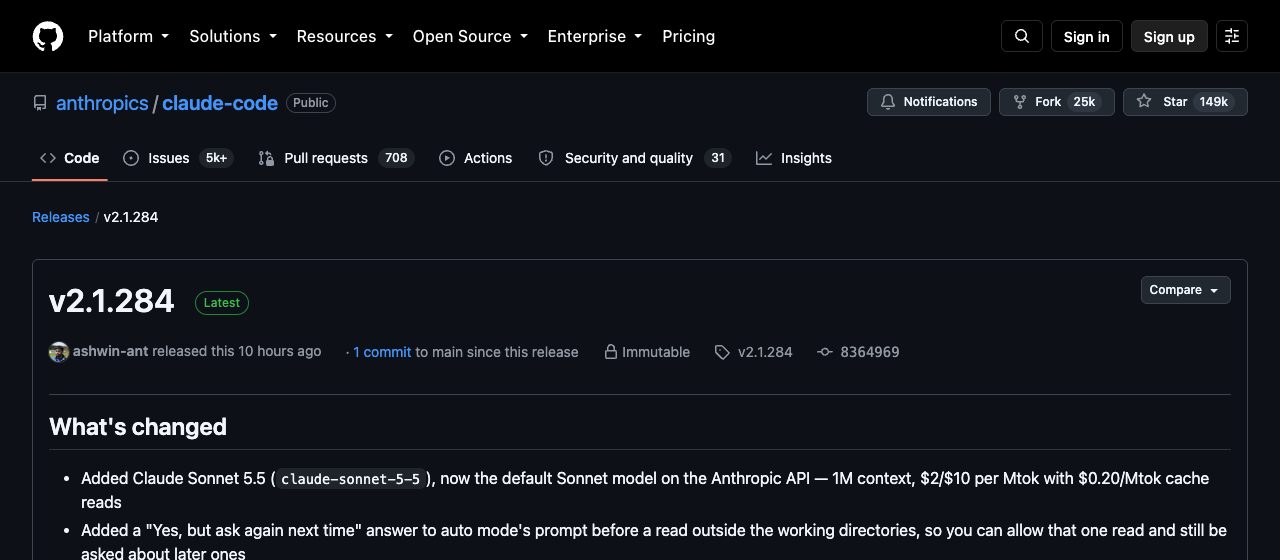
Anthropic API의 기본 Sonnet 모델이 Sonnet 5.5로 바뀌었습니다. 모델 ID는
claude-sonnet-5-5입니다.기본 effort는 쓰는 곳마다 다릅니다. Claude Code와 Claude 앱에서는 Medium, Claude Platform(API)에서는 High가 기본입니다. 낮출수록 빨리 답하고 토큰을 덜 씁니다. 높일수록 오래 생각하고 더 꼼꼼히 확인합니다.
사고(thinking)를 끄고 Sonnet을 쓰던 분은 설정을 바꿔야 합니다. 새
between_tools설정으로 옮겨야 하고, 자세한 방법은 Anthropic 이전 안내에 있습니다.세션 중간에 계정을 바꾸는 경우를 주의합니다. Sonnet 5.5부터 사고 내용이 그것을 만든 계정에 묶입니다. 대부분의 개발자는 차이를 느끼지 못할 거라고 합니다. 다만 Claude Code에서 세션 도중 계정을 바꾸는 것처럼 대화를 계정 사이에 옮긴다면 바뀐 점을 Anthropic 문서에서 확인해 두는 게 좋습니다.
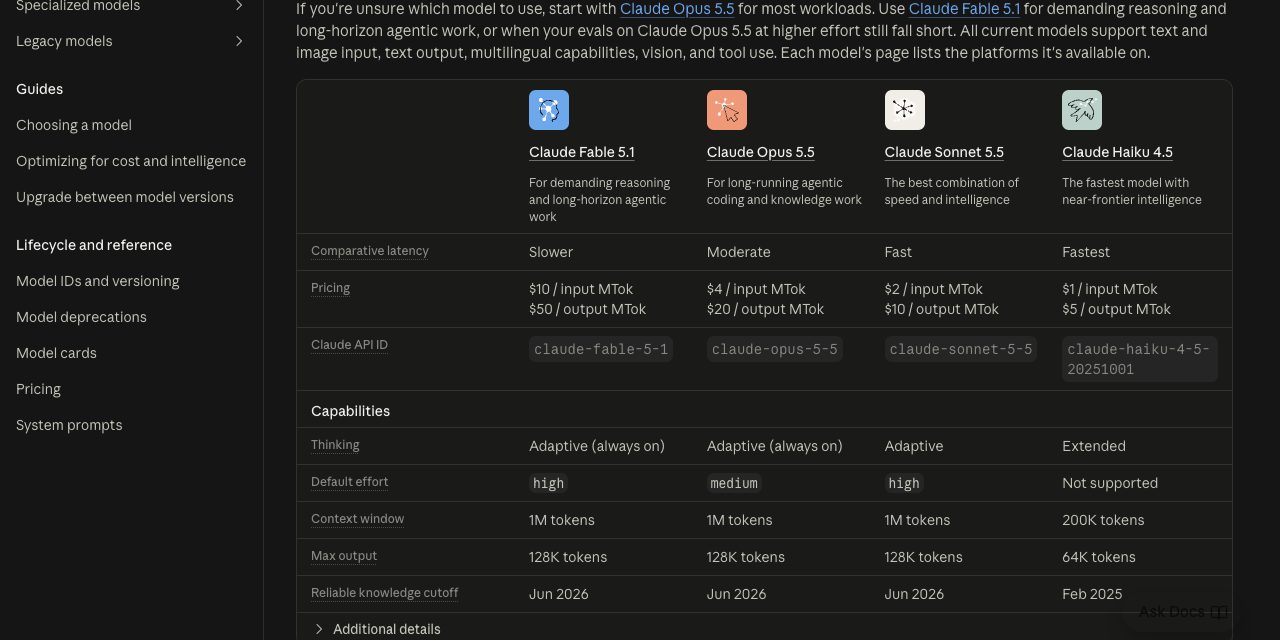
Claude 문서의 모델 표에는 컨텍스트 창 100만 토큰, 최대 출력 12만 8천 토큰, 신뢰할 수 있는 지식 기준 시점 2026년 6월로 나와 있습니다.
안전장치
사이버보안. 사이버 능력이 Sonnet 5보다 크게 올라서 Opus 5.5와 비슷한 안전장치를 붙였습니다. 평소 개발하며 버그를 찾고 고치는 일은 그대로 됩니다. 위험도가 높은 사이버보안 작업은 눈에 보이게 Sonnet 5로 넘어갑니다.
생물학. Sonnet 5와 같은 안전장치를 씁니다.
추론 추출 방지. 가짜 계정 수천 개로 모델 능력을 대량으로 빼 가는 증류(distillation) 공격을 막는 분류기를 Sonnet 모델에서는 처음 붙였습니다.
먼저 써 본 회사들의 평가
발표문에 실린 고객사 평가입니다. 각 회사가 자기 환경에서 잰 값입니다.
Slack: 프롬프트를 바꾸지 않았는데 Slackbot 오프라인 평가 대부분에서 Sonnet 5보다 나았고, 출력 토큰이 약 14% 적었습니다.
Zendesk: 실제 지원 사례 수백 건에서 티켓 처리가 20% 빨랐습니다.
Balyasny Asset Management: 금융 과제 2,441개에서 답 하나에 쓴 토큰이 약 12만 1천 개로, Sonnet 5의 49만 7천 개보다 크게 적었습니다.
Lovable: 코딩 평가에서 도구 호출이 3분의 1 줄고 셸 실행은 약 절반이었습니다.
Base44: 실제 앱 118개를 만든 결과 Opus 5 수준이었고, 앱 하나당 평균 3.6번 반복으로 끝냈습니다. Opus 5는 7.7번이었습니다.
볼 때 주의할 점
벤치마크 점수와 비용 비교는 Anthropic이 직접 밝힌 수치입니다. 독립적으로 재현한 결과가 아닙니다.
고객사 평가도 각 회사가 발표문에 실은 것입니다.
지식 노동 평가(GDPval-AA, AA-Briefcase)는 출시 전 배포판으로 쟀습니다. Anthropic은 그 배포판에 구조화된 출력을 쓰는 요청의 응답을 떨어뜨릴 수 있는 버그가 있었고 지금은 고쳤다고 밝혔습니다.
일부 평가는 GPT-6 Sol 점수가 공개되지 않아 GPT-5.6 Sol과 비교했습니다.
출처
Anthropic, Introducing Claude Sonnet 5.5 (2026-09-28)
Anthropic, Claude Code v2.1.284 릴리스 노트 (2026-09-29 03:02 KST)
Claude 문서, Models overview
공개 자료를 정리한 글입니다. 수치는 각 출처를 인용한 것이며 독립적으로 검증한 결과가 아닙니다. 본문의 화면은 출처 페이지를 2026-09-29에 캡처한 것입니다.
댓글
첫 댓글을 남겨 보세요.
로그인하면 댓글과 답글을 남길 수 있어요.